Guia de problemas en el desarrolo de software (WIP)
Indice
Introduccion
La intencion de este documento es intentar explicar situaciones que pueden presentarse en cualquier parte del ciclo del desarrollo de software, hablar de la raiz de la problematica hasta describir de que manera se puede solucionar.
A quien esta enfocado
Cualquier persona que quiera o se vea involucrada en el desarrollo de algun sofware.
Race conditions
Concepto
En terminos simples es una situacion en la que dos procesos actualizan el mismo recurso a la vez, resultando en un error de consistencia en la informacion. Esto puede ocurrir en sistemas centralizados o distribuidos.
Algunos ejemplos que podemos llegar a ver son:
- Dos hilos del CPU accediendo a un contador y actualizandolo, lo esperado es que se reflejen ambas actualizaciones pero debido a la condicion de carrera solo se muestra una. Imagen 1
- En un sistema de tienda en linea, dos usuarios envian concurrentemente la peticion para comprar un producto con una sola existencia, el sistema, equivocadamente, procesa ambas peticiones vendiendo el mismo producto a los dos clientes.
- En un sistema bancario, un cliente realiza dos retiros al mismo tiempo de 10$ y y el cliente termina con 20$
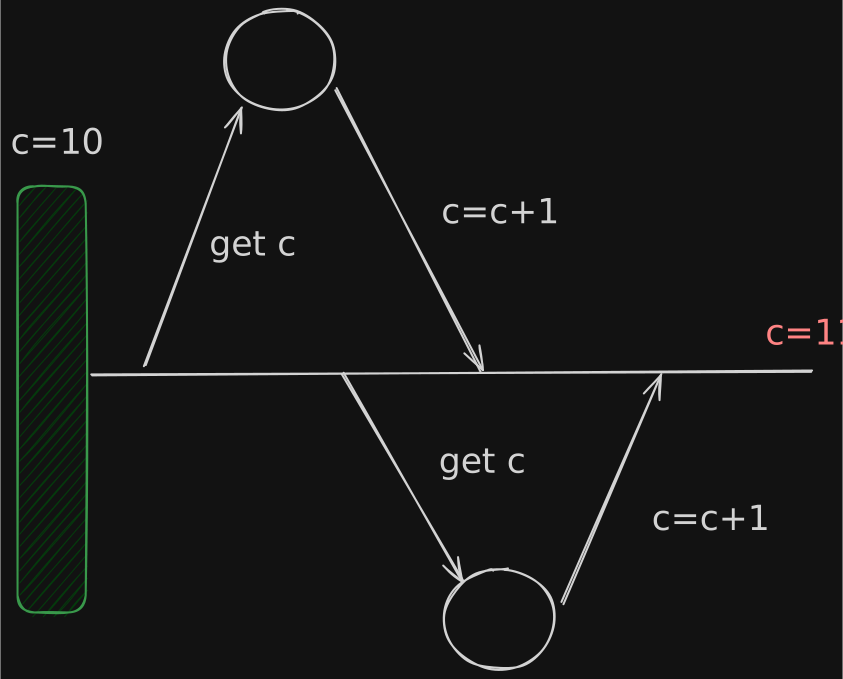 Imagen 1. Una race condition debido a que dos procesos modifican un recurso y termina en un estado incosistente
Prevencion y Solucion
- Locks (Mutual Exclusion)
Una forma de prevenir las race conditions es con ayuda de locks. En el ejemplo en el que dos hilos estan modificando el mismo contador, podemos agregar un lock a dicho contador para que cuando este siendo utilizado por el hilo 1, ningun otro hilo pueda hacer uso de el, asi en cuanto el hilo 2 quiera realizar el incremento, tendremos el resultado esperado. Imagen 2
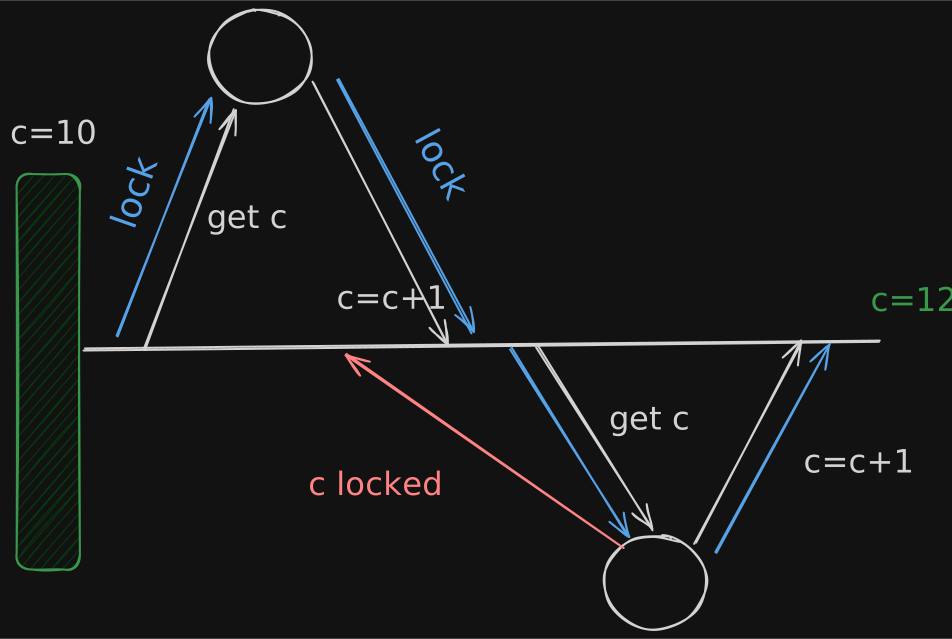 Imagen 2. Dos procesos modificando el mismo recurso pero ahora con ayuda de locks, previniendo una race condition.
Como nota, esta forma de solucionar las race conditions puede dirigirnos a otra problematica conocida como deadlock (ver pagina x si se escribe) como introduccion breve, esto podria ocurrir en un supuesto: proceso A bloquea el recurso 1 y necesita el 2 para continuar, proceso B bloquea el recurso 2 pero necesita el 1 para continuar.
Esto tambien puede implementarse en un escenario donde trabajemos con una base de datos, podemos agregar un lock para una fila y que esta se bloquee hasta que terminemos de actualizarla, evitando asi que se modifique en otra parte.
En el escenario en donde hay un producto con una ultima existencia, el usuario que haga la primer lectura del producto, va a bloquear esa fila para que ningun otro cliente pueda utilizarla, el usuario b se quedaria colgado esperando a que el usuario a termine de comprar.
Desde un punto de vista de producto, no es muy comodo que la aplicacion o sitio web se quede congelado debido al lock, afortunadamente hay otras formas de poder manejar las race conditions sin exponernos a deadlocks o tiempos de espera.
- Atomic operations
Como nos podemos dar cuenta el escenario para que se de una race condition debe ser algo como lo siguiente: dos procesos obtienen un valor para realizar una modificacion, leen el mismo valor inicial y no esperan a que un proceso o el otro termine de hacer su escritura.
Las operacion atomicas son una alternativa a no querer bloquear el recurso y dejar esperando a los demas procesos. Su idea principal es la siguiente.
Si tenemos una funcion que incremente en 1 un contador, dicha funcion puede generar una race condition si es ejecutada por dos procesos al mismo tiempo, ya que ambos leeran el valor incial (digamos 10) y cuando hagan el incremento llegara a 11, siendo que lo esperado es que llegue a 12.
Convertir nuestra operacion de incremento en atomica conlleva especificar al CPU que la ejecucion de Leer-Modificar-Escribir es una sola operacion y no 3 distintas.
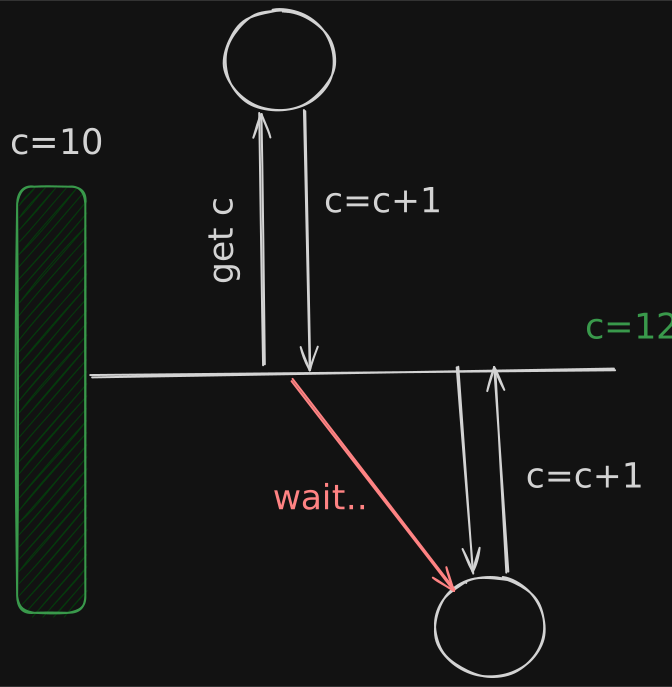 Imagen 3. El proceso A realiza su incremento, el proceso B quiere leer el contador pero se le indica que espere hasta que A termine, al final realiza su ejecucion
En este caso si otro proceso quiere modicar el mismo recurso va a tener que esperar (no congelarse, veremos eso mas a detalle) a que el primer proceso termine de realizar la la operacion (Leer-Modificar-Escribir en conjunto) y despues ejecutarse.
A diferencia de los locks, utilizar operaciones atomicas no deja congelado al segundo proceso que intente acceder al recurso, en su defecto lo que sucede es un retraso entre ejecuciones. Utilizando locks el sistema operativo tiene que dormir un proceso, ejecutar a quien tomo como ganador, despues despertar al proceso en reposo y ejecutarlo, siendo esto mucho mas demandante para el CPU.
Para poder tener dicho beneficio tenemos que asegurarnos que nuestra operacion es atomica, es decir indivisible, si es de mas de una instruccion es posible que un proceso pueda meterse entre esas ejecuciones.
Las operaciones atomicas tienen la ventaja de que son libres de poder crear algun deadlock.
- Optimistic Concurrency Control
Esta estrategia para manejar el esceneario de una race condition se apoya en algun valor que ayude a representar cual es el estado mas reciente de la informacion.
Hay distintas implementaciones para controlar la concurrencia de manera optimista:
- Numero de version.
En esta implementacion, agregamos un contador que nos va a ayudara a llevar registro de la version de la informacion.
El proceso es bastante simple, cuando leemos la informacion tambien vamos a tener un numero de version, cuando hagamos la escritura tendremos que agregar una validacion que especifique que el numero de version es el leido, si coinciden, podemos actualizar la fila, si el valor de nuestra version es diferente al que esta en la base de datos, quiere decir que desde otro lado se realizo una modificacion y por lo tanto nuestra modificacion va a descartarse.Ilustracion 4 y 5
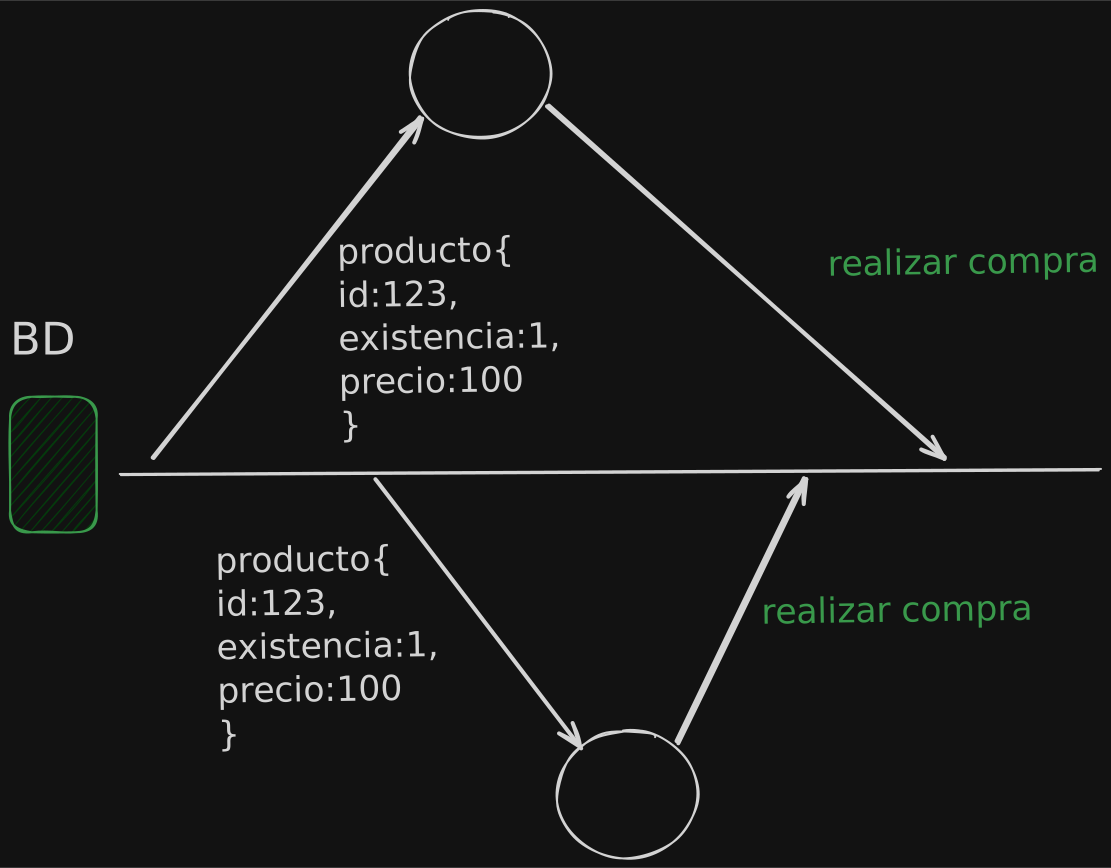 Ilustracion 4. Dos personas logran comprar un producto del cual solo hay 1 existencia
Con un numero de version..
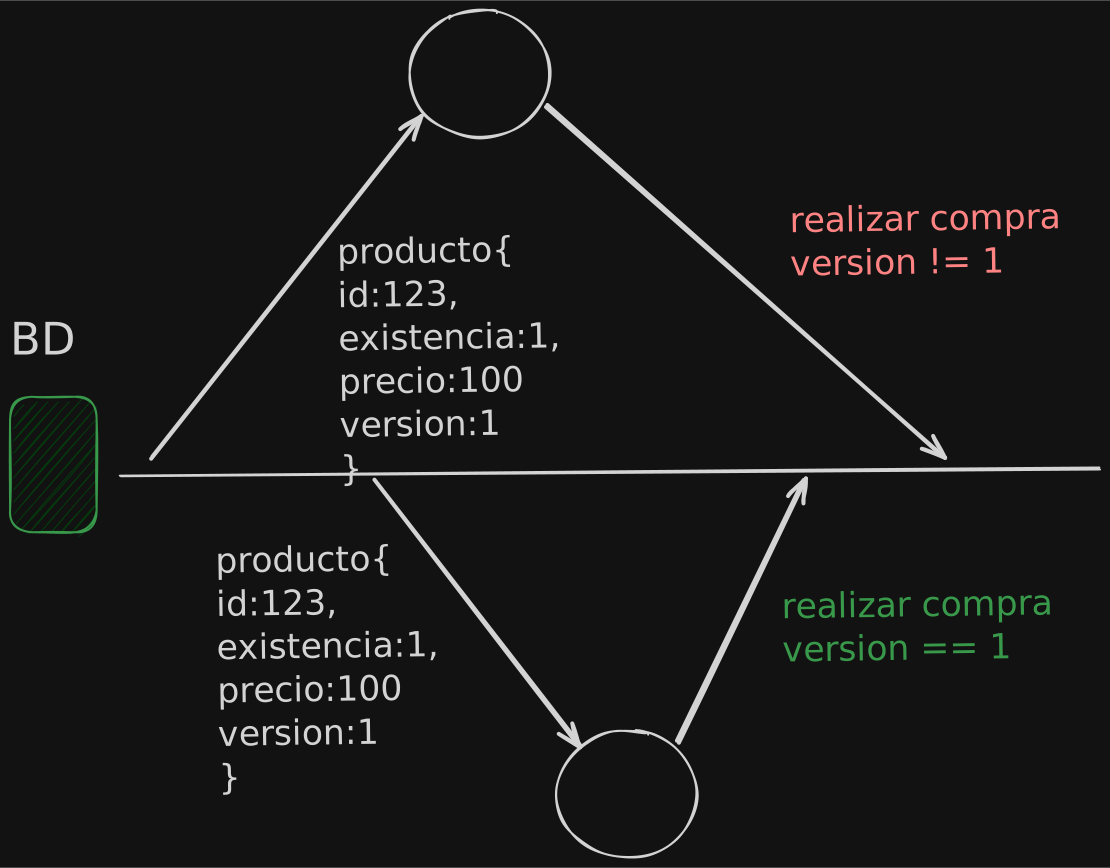 Ilustracion 5. Agregando un numero de version a la tabla de productos el sistema corrobara que el valor en la base de datos es el mismo al pagar,que al momento de leer la informacion del producto
Como nota en el supuesto en que nuestra peticion se cancela porque contamos con una version diferente a la actual, lo ideal seria implementar algun tipo de re-intento, pero dejarle en claro al usuario que la accion que realizo no se completo.
- Timestamp
Una alternativa a utilizar numero de version para nuestra informacion, es llevar el registro mediante fecha y hora(timestamp), similar al uso de versiones, aqui tenemos una columna que lleve el registro de la fecha y hora, cuando se va a actualizar un registro se lee y se crea el timestamp, se hacen los cambios y al momento de escribir se valida que el timestamp leido siga siendo el que se encuentra en la base de datos, en caso de no serlo, se descartan los cambios, si es el mismo timestamp, los cambios pueden guardarse.
En sistemas distribuidos no es muy recomendable hacer uso de esta solucion, ya que cabe la posibilidad de que se pie a otro problema debido a la variabilidad de los timestamps entre servidores(Unreliable clocks Designing Data Intensive Applications).
- Comparacion
En lugar de estar revisando un contador o timestamp, podemos comparar la informacion con el estado deseado antes de actualizar, es decir, leer la informacion y en cuanto se haga la escritura agregar la validacion de que el valor sigue siendo el esperado, si coincide, hacer los cambios, en caso de que no sea asi, fallar o re-intentar.
- Llaves de idempotencia
Otra manera de evitar las race conditions, es haciendo uso de llaves de idempotencia(leer Idempotencia en pag x). Este es un termino que vermos mas adelante pero para fines practicos, las llaves de idempotencia nos ayudan a llevar un registro(similar a un numero version o un timestamp) para que nuestro sistema sepa si una accion ya se ha realizado.
En un escenario real las llaves de idempotencia actuarian de la siguiente manera:
- Cliente da click dos veces a boton de comprar
- El servidor recibe ambas peticiones y las procesa
- El cliente termina con dos compras realizadas.
Para implementar llaves de idempotencia y evitar que esto ocurra podriamos agregar a nuestra base de datos algo como lo siguiente:
Dentro de la tabla de pagos agregamos una columna que contenga la llave de idempotencia con reestriccion de UNIQUE, el cliente va a generar dicha llave en cuanto vaya la pagina de checkout y enviarla al servidor para procesar el pago, esto va a evitar que en caso de que llegue mas de 1 peticion rechazara el resto debido a la validacion UNIQUE de la base de datos.
Insecure Direct Object Reference
Concepto
IDOR es una vulnerabilidad que se presenta cuando omitimos implementar practicas de seguridad que protejan el acceso a la informacion de nuestro software. Un concepto muy importante para entender este problema, es el de, ownership. Es decir, que a un usuario le pertenece cierta informacion.
Por ejemplo en una aplicacion en la que existan perfiles de usuario, se debe verificar que quien esta intentando editar el contenido del perfil, es el propietario de ese perfil y no alguien mas, aun y si el resto de personas conocen el identificador del usuario, la aplicacion debe de imponer la validacion necesaria para evitar que alguien mas edite esa informacion.
Escenario
Veamos como estaria presente la vulnerabilidad en el ejemplo anterior.
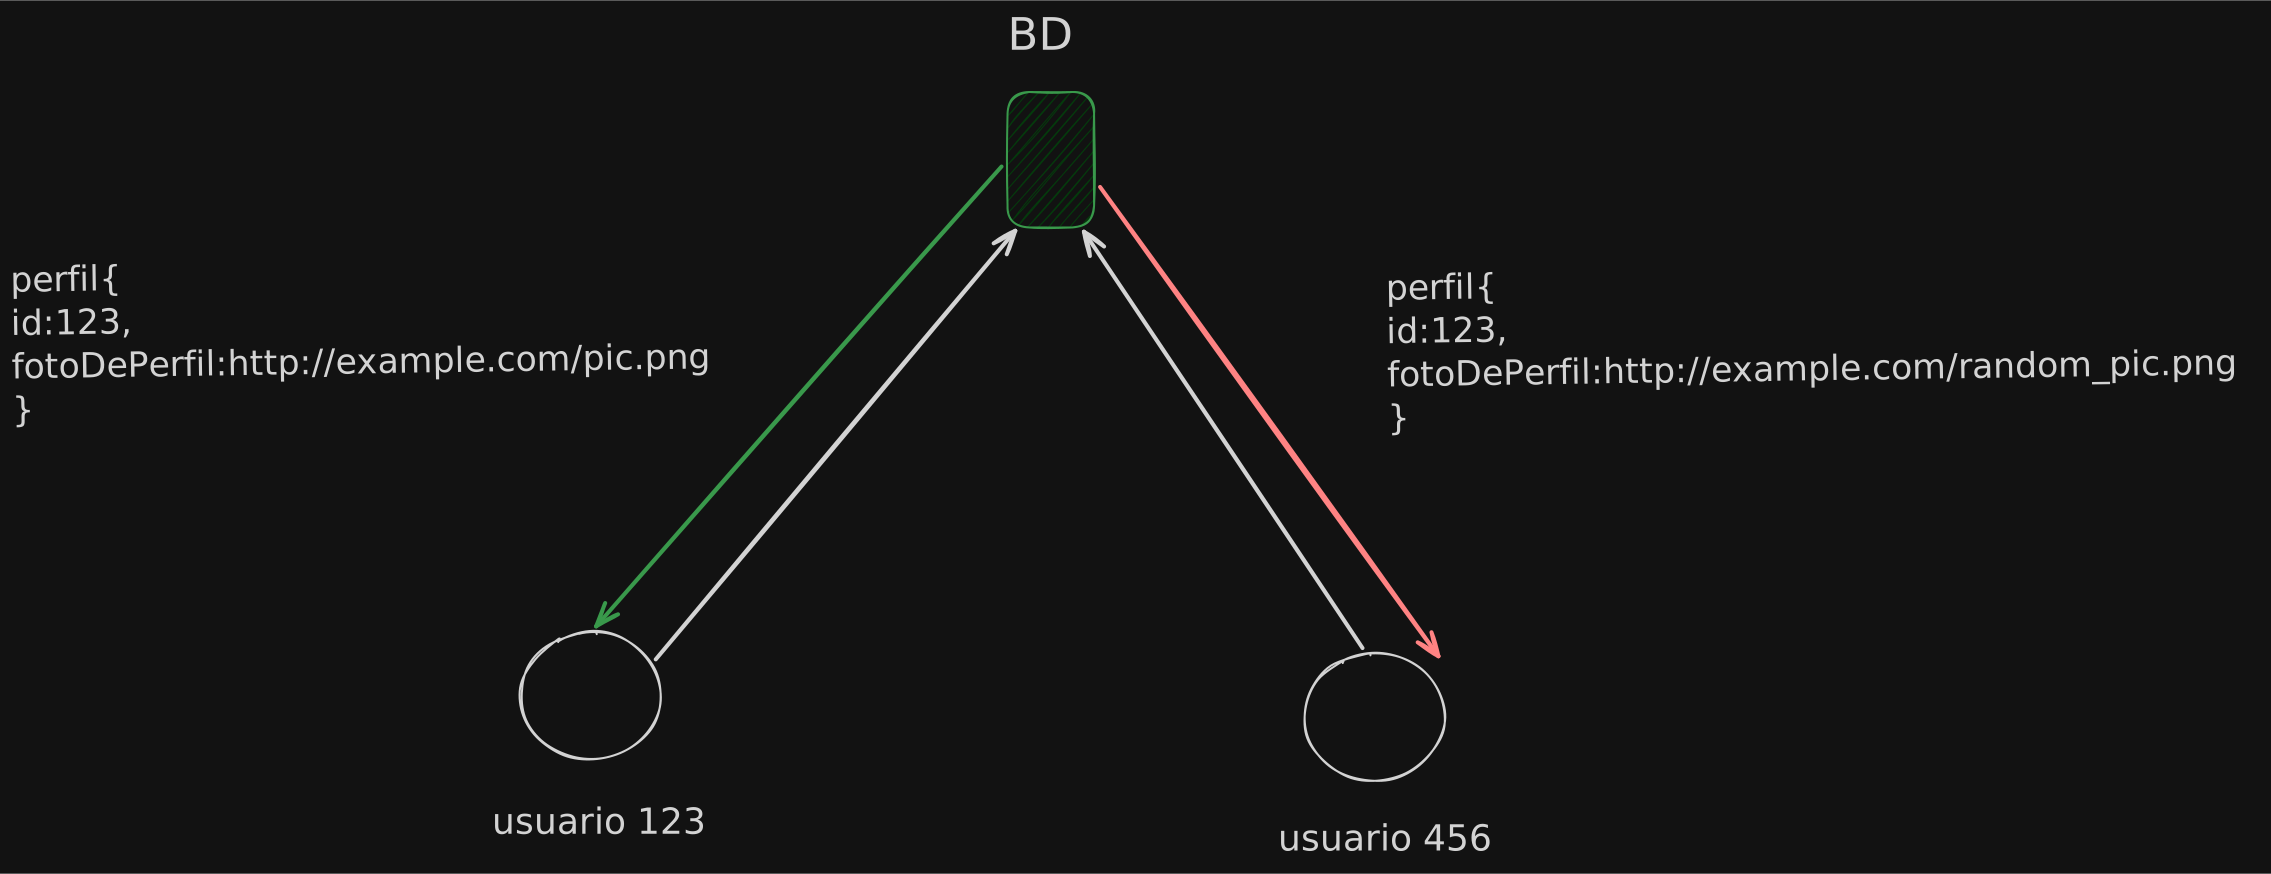 Ilustracion 6. Un usuario puede modificar el contenido del perfil de otro solo por conocer el identificador
Como podemos ver en la ilustracion 6, el usuario 456 es capaz de editar el perfil de otro usuario solo por conocer el identificador, haciendo vulnerable a nuestra aplicacion, los usuarios deberian estar limitados a editar solo su proppio perfil.
IDOR Horizontal
A este escenario en el cual un atacante puede acceder a informacion que no deberia poder ver, se le conoce como escalado horizontal. Para mitigar esta vulnerabilidad en el ejemplo anterior, tenemos que verificar que el usuario no este intentando modificar el perfil de alguien mas.
Veamos como seria el codigo para cuando la vulnerabilidad esta presente.
app.MapPatch("profile/{id}", async (int id, [FromBody] UpdateDTO profileUpdate, ProfileDB db) =>{
    var result = await db.UpdateProfile(id,profileUpdate);
    return result;
});

async Task<StatusCodes> UpdateProfile(int id,UpdateDTO dto) {
    var dbObject = await _context.Profiles.FirstOrDefaultAsync(p=>p.Id == id);
    if (dbOject == null)
        return StatusCodes.Status404NotFound;
    dbObject.Email = dto.Email
    dbObject.Name = dto.Name;
    await _context.SaveChangesAsync();
    return StatusCodes.Status200OK;
}
Ilustracion 7. IDOR presente en endpoint para editar perfil
Con el codigo anterior nuestro endpoint esta expuesto a que todos los usuarios sean capaces de editar el perfil de cualquier usuario.
Ahora veamos como realizar la validacion correcta para eliminar la referencia directa al objeto (perfiles).
app.MapPatch("profile/{id}", async (int id, [FromBody] UpdateDTO profileUpdate, ProfileDB db) =>{
    var userId = User.FindFirstValue(ClaimTypes.NameIdentifier);
    var result = await db.UpdateProfile(id,profileUpdate,userId);
    return result;

});

async Task<StatusCodes> UpdateProfile(int id, UpdateDTO dto, int userId) {
    //Agregamos una condicion a la busqueda, validando que el record a actualizar sea el del usuario actual
    var dbObject = await _context.Profiles
                        .FirstOrDefaultAsync(p=>p.Id == id && p.UserId == userId);
    //En caso de que no lo sea cancelamos la edicion.
    if (dbOject == null)
        return StatusCodes.Status404NotFound;

    dbObject.Email = dto.Email
    dbObject.Name = dto.Name;
    await _context.SaveChangesAsync();
    return StatusCodes.Status200OK;
}
Ilustracion 7. Agregando el check de ownership para prevenir la vulnerabilidad
IDOR Vertical
Se le conoce como escalado vertical al ataque que permite al usuario elevar sus privilegios. hablando de IDOR podemos tener presente esta vulnerabilidad si no realizamos las validaciones pertinentes en endpoints que involucren a usuarios administradores.
Por ejemplo
http://www.example.com/api/reset-password?userid=123Si tenemos un endpoint como este, en el que
- Pasamos el ID del usuario directamente como parametro de consulta
- Y ademas el servidor no valida que quien esta haciendo la peticion sea el usuario en si.
Un atacante podria ejecutar esta accion sobre un usuario administrador, cambiar su contraseña y elevar sus privilegios a dicho nivel.
Fuentes chidas
Problema N+1
Concepto
El problema N+1 es una situacion bastante comun en el desarrollo de aplicaciones que involucran una capa de persistencia de datos. Este problema se presenta cuando realizamos N+1 llamadas a la base de datos que podrian ahorrarse si construyeramos una consulta mas optmizada que incluya la informacion relacionada. (No solo puede presentarse en lectura si no tambien en escritura).
Escenario
Imaginemos una aplicacion en la que tenemos informacion acerca de productos y sus categorias, gracias a nuestras clases de bases de datos sabemos que debemos normalizar nuestras tablas, por consiguiente, creamos una para los productos y otra para las categorias, las cuales van a estar relacionadas.
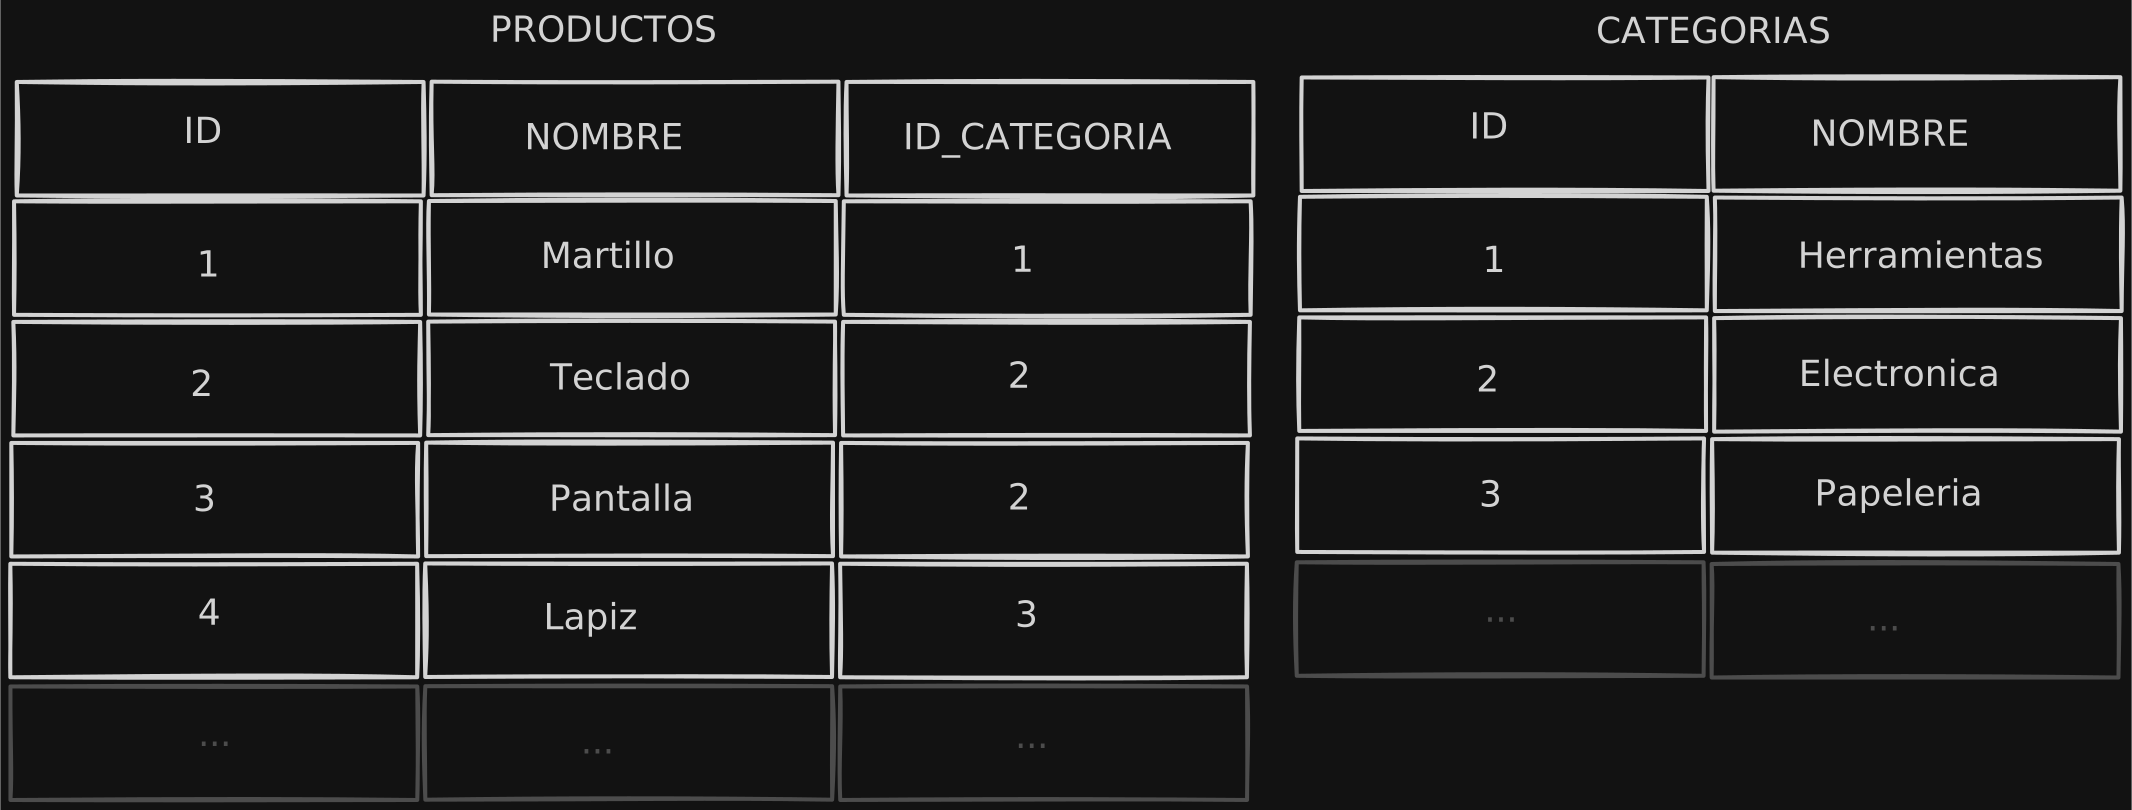 Ilustracion 7 Tablas represeentando la relacion entre productos y categorias
Si queremos mostrar la informacion de los productos en nuestra aplicacion, es posible que nos resulte logico el realizar una llamada para obtener todos los productos y para cada producto realizar una consulta para obtener el nombre de su categoria. Representado en codigo veriamos algo como lo siguiente.
async Task<List<Product>> GetProducts() {
    var products = await _context.Products.ToListAsync();

    for(var product in products){
        var category = await _context.Categories.FirstOrDefaultAsync(c=>c.Id == product.CategoryId);
        product.CategoryName = category.Name;
    }

    return products;
}
Si nos damos cuenta la cantidad de consultas que estamos realizando en este ejemplo son, 5. Una consulta para obtener el listado de productos y despues para cada uno realizamos una consulta mas para obtener la informacion de su categoria (4 consultas para categorias + 1 consulta para el listado).
Con la cantidad de datos manejada en el ejemplo es muy probable que el rendimiento de nuestra aplicacion no se vea afectado por dicha situacion, pero en un escenario real en el cual manejemos cientos o miles de registros, realizar una peticion para obtener informacion relacional puede aumentar significativamente el tiempo de respuesta.
Solucion
Siguiendo con el ejemplo anterior, la forma en que podemos prevenir este problema es (de nuevo recordando nuestras clases de bases de datos), hacer uso de JOINS, a pesar de que estemos manejando la informacion con un ORM(Object-relational mapping) la herramienta debe de permitirnos realizar uniones entre tablas relacionadas.
Corrigiendo el problema N+1 en el codigo del ejemplo, nuestra funcion se veria de la siguiente manera.
async Task<List<Product>> GetProducts() {
    var products = await _context.Products.Include(p => p.Category).ToListAsync();

    return products;
}
Esta seria la representacion de las consultas SQL que se realizan en ambos ejemplos.
-- N+1
SELECT * FROM Products;

SELECT * FROM Categories WHERE ID = 1;
SELECT * FROM Categories WHERE ID = 2;
SELECT * FROM Categories WHERE ID = 2;
SELECT * FROM Categories WHERE ID = 3;

-- Utilizando Join
SELECT * FROM Products as P
INNER JOIN Categories as C
on P.CategoryId = C.Id;
Acoplamiento fuerte
Concepto
Podemos definir como acoplamiento a la existencia de una dependencia entre distintos modulos de nuestro sistema, que cuando modifiquemos un modulo tengamos que tambien realizar modificaciones en modulos que dependen de este. El acoplamiento no esta limitado a la forma en que esta estructurada el proyecto/codigo, tambien esta presente en el funcionamiento del sistema. Decimos que hay acoplamiento fuerte cuando un error en una llamada a un modulo hace que el flujo principal falle.
Vamos a definir un escenario para ver los dos puntos mencionados de acoplamiento fuerte: Imaginemos que estamos trabajando en un sistema de ventas en linea, dicho sistema cuenta con distintos modulos en la aplicacion los cuales se comunican entre si, para este escenario nos enfocaremos en la interacion entre el modulo de ventas y de notificaciones.
Error 1.
Como ya lo mencionamos la primer foram en que podemos contar con acoplamiento fuerte es que la comunicacion entre modulos sea mediante instanciamiento directo, es decir que; en este caso, la clase Ventas llame directamente a un objecto de la clase Notificaciones.
Para eliminar el acoplamiento fuerte en este escenario, lo que tenemos que realizar es eliminar el trabajar con instancias de los modulos (clases), en su defecto vamos a trabajar con abstracciones e interfaces. Con esto logramos que; en este caso, el modulo de ventas prescinde de conocer como trabaja el modulo de notificaciones, solo sabe que es lo que hace, pero no el como.
El acoplamiento fuerte en el codigo se veria de la siguiente manera.
class ServicioVentas{
    public servicioNotif = new ServicioNotificaciones();

    public async Task ProcesarVenta(VentaDTO dto){
        //...codigo..

        await servicioNotif.EnviarNotificacion("Nueva venta");
    }
}

class ServicioOfertas{
    public servicioNotif = new ServicioNotificaciones();

    public async Task EnviarOferta(OfertaDTO dto){
        //...codigo..

        await servicioNotif.EnviarNotificacion("Mira esta oferta...");
    }
}


class ServicioNotificaciones{
    public async Task EnviarNotificacion(string mensaje){
        //codigo para enviar notificaciones
    }
}
En el ejemplo anterior contamos con acoplamiento fuerte, ya que ambos servicios Ofertas y Ventas estan trabajando creando un objeto del modulo de notificaciones directamente; cuando hagamos cambios en la classe de ServicioNotificaciones vamos a tener que ir a reflejar dichos cambios en todos los lugares en que se este utilizando.
Como podria ser: agregar un nuevo parametro al metodo de enviar notificacion, que el constructor tenga que recibir una cadena de conexion, o incluso el que querramos tener varias implementaciones de notificaciones, por ejemplo, un servicio para sms y otro para correo.
Solucion 1.
Para solucionar esto (como ya mencionamos repetidas veces) hay que utilizar abstracciones, en los lenguajes de programacion podemos hacer uso de ellas mediante, clases abstractas o interfaces. Al hacer esto vamos a definir como debe ser el comportamiento de nuestro modulo, para despues crear una implementacion de dicha abstraccion.
En este caso la interfaz para el modulo de notificaciones se veria de la siguiente manera:
interface IServicioNotificaciones{
    Task EnviarNotificacion(string mensaje);
}
Y una implementacion se veria asi:
class ServicioNotifiacionesSms : IServicioNotificaciones{
    //Al momento de heredar de una interface, C# nos obliga a implementar los metodos definidos en ella(comportamiento)

    public async Task EnviarNotificacion(string mensaje){
        //codigo para enviar notifiacion sms...
    }
}
Y las llamadas al servicio de notificaciones serian de esta forma:
class ServicioOfertas{
    private readonly IServicioNotificaciones _servicioNotif;

    public ServicioOfertas(IServicioNotificaciones servicioNotif){
        _servicioNotif = servicioNotif;
    }

    public async Task EnviarOferta(OfertaDTO dto){
        //...codigo..

        await _servicioNotif.EnviarNotificacion("Mira esta oferta...");
    }
}
Esto nos brinda multiples beneficios, el primero obviamente es que ahora tenemos una dependencia de una abstraccion no de una implementacion, por lo tanto nuestra clase de ventas solo va a conocer que acciones realiza el servicio de notificaciones, mas no como las hace. Ademas tambien hacemos mas sencillo el tener varias implementaciones, por ejemplo podriamos tener otro servicio llamado
ServicioNotificacionesCorreoy heredar de la interfaz.
Escenario 2.
La segunda manera en que el acoplamiento fuerte puede afectar a nuestra aplicacion, es cuando un error en una dependencia hace que el modulo principal falle. El modulo principal esta fuertemente acoplado a la dependencia.
Solucion 2.
Para este tipo de escenarios no basta con solo trabajar con abstracciones e interfaces en el codigo, el que nuestro modulo de notifiaciones falle puede ser por algo ajeno a como esta construida nuestra aplicacion (time-out,el servicio de terceros esta caido, error en la red, etc),
En este tema solo vamos a enfocarnos en como hacer que nuestro flujo no se caiga por una falla en un modulo, mas adelante veremos que hacer para procesar esos fallos despues de que el modulo se recupre.
Para que un fallo en un modulo escale en que nuestro proceso completo se rompa, podemos:
- Encerrar en un try-catch la llamada al modulo, si este falla el error no va a escalar al hilo principal y detener la ejecucion.
- Desacoplar los modulos mediante patrones de diseño.
- Utilizar background jobs
- Utilizar Task Queues
1. Try-catch
En esta sitaucion si nuestra llamada al servicio de notificaciones llegara a dar una excepcion la funcion para procesar la venta fallaria
class ServicioVentas{
    private readonly IServicioNotificaciones _servicioNotif;

    public ServicioVentas(IServicioNotificaciones servicioNotif){
        _servicioNotif = servicioNotif;
    }

    public async Task ProcesarVenta(OfertaDTO dto){
        //...codigo..
        // Esta funcion da una excepcion, el resto de la funcion `EnviarOferta` falla
        await _servicioNotif.EnviarNotificacion("Mira esta oferta...");
        //...codigo...
    }
}
La forma mas sencilla de resolver esto es haciendo uso de try-catch para capturar la excepcion que pueda surgir en el modulo de notificaciones.
class ServicioVentas{
    private readonly IServicioNotificaciones _servicioNotif;

    public ServicioVentas(IServicioNotificaciones servicioNotif){
        _servicioNotif = servicioNotif;
    }

    public async Task ProcesarVenta(OfertaDTO dto){
        //...codigo..
        try{
            //Estando dentro de un try-catch la excepcion se va a capturar y el resto de `ProcesarVenta` se ejecutara con normalidad
            await _servicioNotif.EnviarNotificacion("Mira esta oferta...");
        }
        catch(ex e){
            Logger.LogError(e.Message);
        }
        //...codigo...
    }
}
2. Patrones de diseño
La primera y mas sencilla de implementar es utilizar un patron de dise;o, en este caso hay 2 opciones
- Patron Observador
Para aplicar esta solucion tenemos que entender de que manera funciona el patron de dise;o Observer. La forma mas sencilla de implementar este patron de dies;o es con 3 elementos.
- El observador (nuestra clase de notificaciones)
- El evento a observar (la creacion de una nueva venta)
- El publicador (la clase de ventas)
El observador va a suscribirse (es decir va a estar escuchando) al evento de VentaNueva que el servicio de ventas publique. De esta manera el servicio de notificaciones va a realizar el proceso de envio de notificacion cada vez que detecte una nueva venta.
 Ilustracion 8. El modulo de notificaciones recibe una actualizacion cada que hay una nueva venta
- Patron Mediador
En este caso en lugar de que los modulos se comuniquen uno a uno, agregamos un controlador llamado, mediador, el cual va a encargarse de realizar la comunicacion entre modulos. Para realizar esta comunicacion utilizamos, mensajes/comandos.
Los comandos (o mensajes) son directamente que acciones queremos decirle al mediador que comunique.
En nuestro escenario de ventas la implementacion seria la siguiente:
- Definimos el comando/mensaje
NuevaVentaNotificacion - El servicio de notificaciones especifica que el procesara dichos comandos.
- El servicio de ventas envia el comando
NuevaVentaNotificacional mediador. - El mediador redirge al servicio indicado.
- La notificacion es enviada.
 Ilustracion 9. El mediador recibe el mensaje de que hay una nueva venta y redirije al modulo responsable del commando
Para esta soluciones estamos ejecutando las funciones de las dependencias con los mismos recursos que los de la aplicacion principal. Las siguientes propuestas son formas de como des-acoplar aun mas la ejecucion de las dependencias.
3. Background Jobs/Workers
Los background jobs nos permiten tener un desacoplamiento aun mayor, ya que estan totalmente separados de la aplicacion principal. Su funcionamiento es muy directo, primero necesitamos definir de que manera nuestro worker va a procesar las tareas, en esta guia nos enfocaremos en dos formas: basados en tiempo y basados en eventos.
Despues de definir cuando se va a ejecutar nuestro worker, necesitaremos crear una cola de tareas (Task Queue), el worker ahora, segun su configuracion, va a ejecutarse y procesar las tareas de nuestra Task Queue
- Workers por tiempo.
El funcionamiento de un worker basado en tiempo es el siguiente: definimos la peridiocidad con la que queremos revisar nuestra cola de tareas (digamos 10 minutos), el job entonces va a leer la tabla con las tareas, procesarlas e irlas eliminando de la cola.
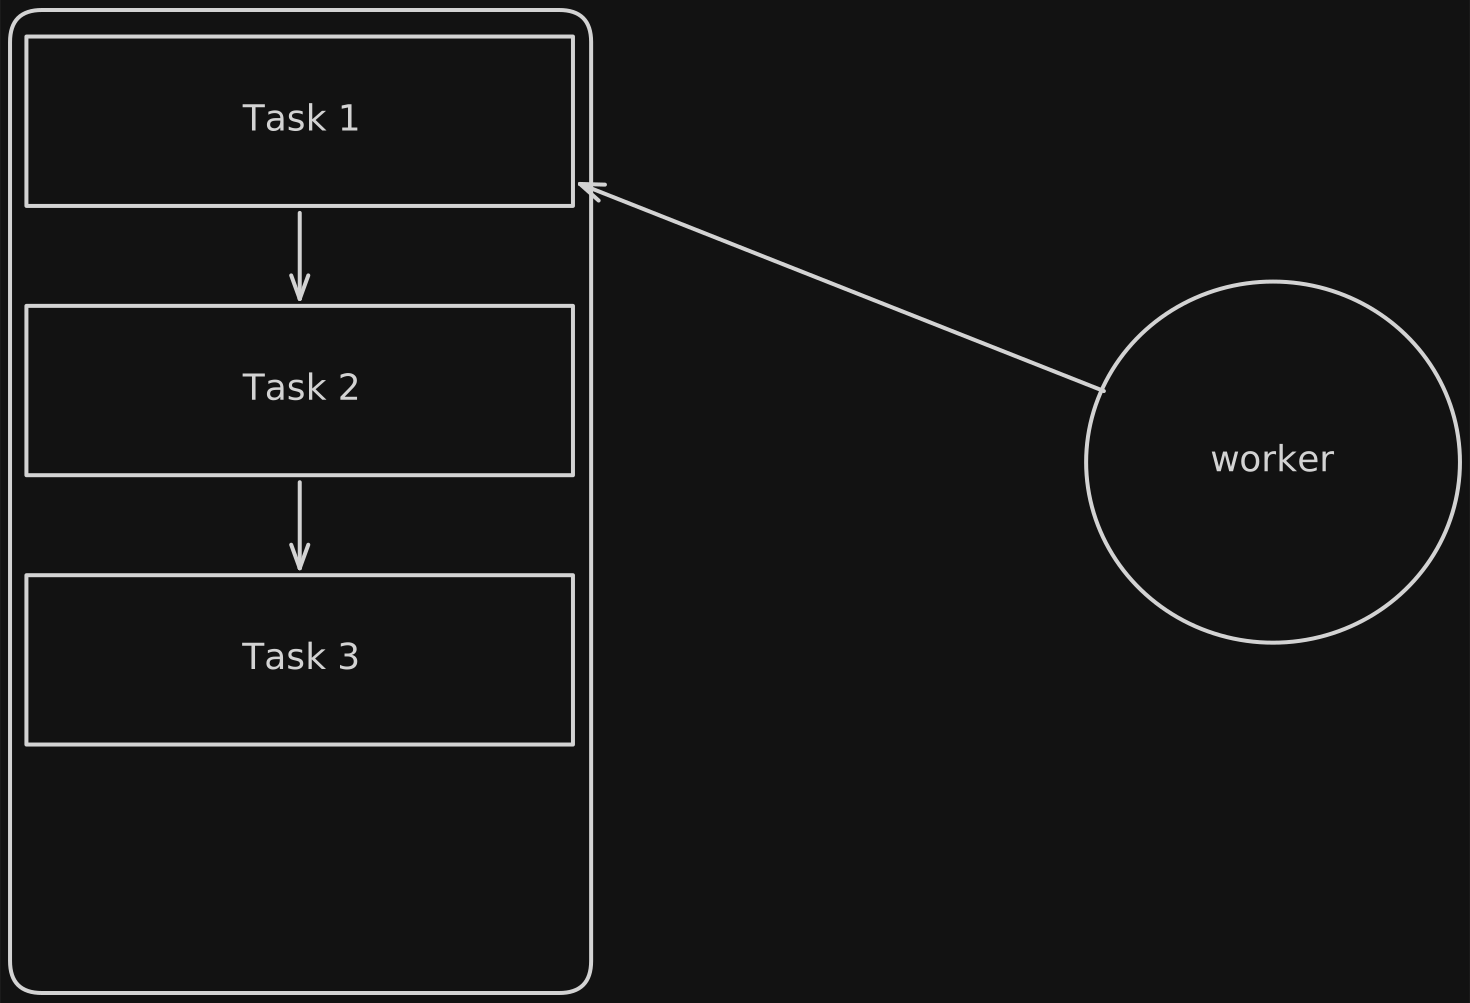
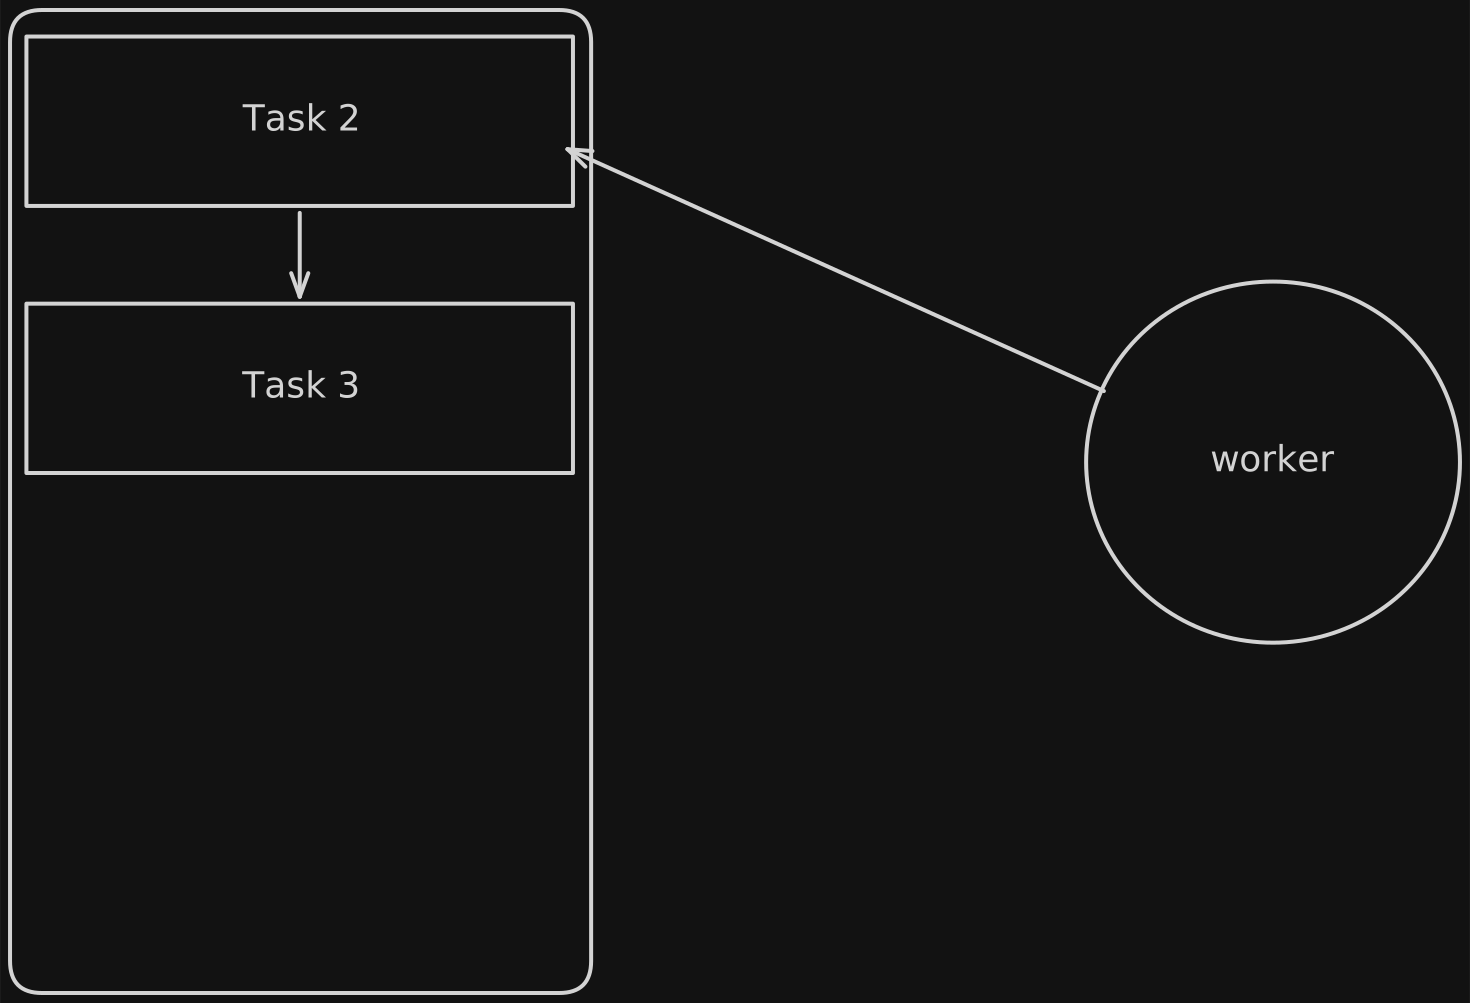
Ilustracion 10. Worker leyendo Task Queue y eliminando las tareas ya procesadas
Un escenario que podria venir a tu mente es el siguiente: que pasa si un worker sigue trabajando y comienza la ejecucion del siguiente? En este supuesto es problable que se de una race-condition
- Workers por eventos.
Esta es una solucion un poco mas elegante, ya que no tenemos que esperar la ejecucion del worker para poder realizar nuestras tareas. Al estar escuchando eventos, podemos definir que nuestro worker se ejecute cada vez que (en nuestro ejemplo) haya un nuevo registro agregado a la tabla de ventas. Asi cada vez que se genere una nueva venta, el worker detectara el INSERT y comenzara a procesar la notificacion.
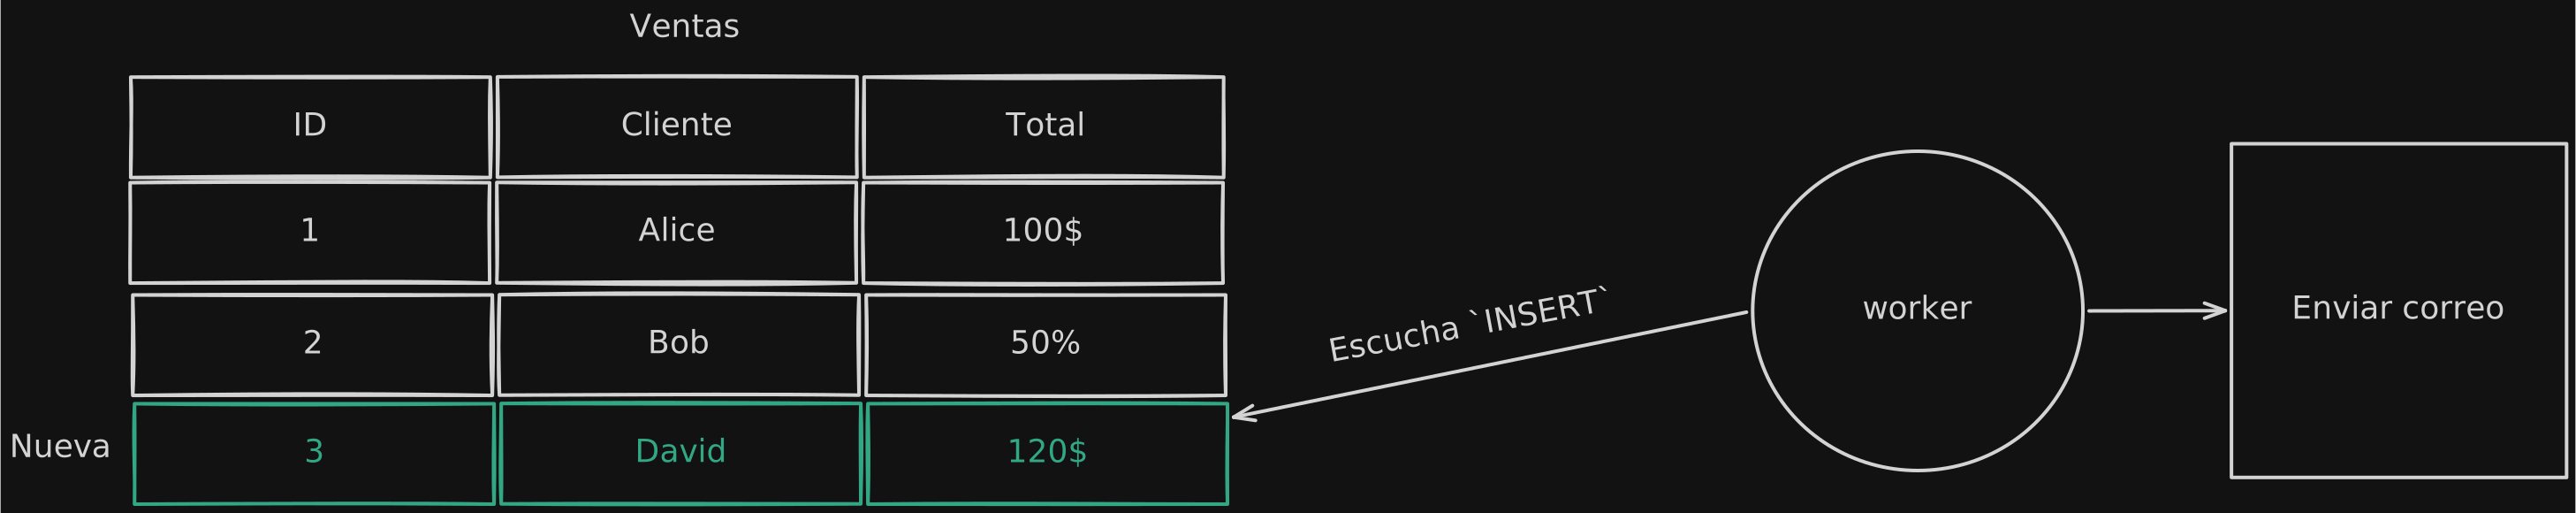 Ilustracion 11. El worker envia los correos cuando detecta un nuevo insert en la tabla de ventas
4. Message Brokers y Tasks Queues (Rabbit MQ. Azure Service Bus, Apache kafka)
La ultima alternativa que veremos para este problema es el uso de Message Brokers, estas herramientas cuentan con la siguiente arquitectura(dise;o). Constan de 3 partes para la comunicacion de mensajes y el procesamiento de tareas.
- Primero tenemos al Publisher que evidentemente es quien va a notificar que hay una nueva tarea por procesar. En nuestro escenario el Publisher es el modulo de ventas.
- Nuestro modulo de notificaciones o correos es el Consumer o a veces tambien llamado Subscriber (si, just como en el patron observador).
- Y por ultimo el Broker, es quien se encarga de toda la orquestracion, escucha al Publisher y redirige los mensajes al Consumer.
Una vez determinamos que partes estan involucradas en la comunicacion, hablemos acerca de los mensajes. Estas herramientas normalmente se utilizan en conjuncion de una Task Queue en ocasiones tambien llamada Topics o Topicos. la idea de esto es que para cada tipo de mensaje exista un Queue.
Con esto se abren dos vertientes en las que el Consumer puede llegar a recibir los mensajes.
- La primera es que el broker le envie directamente que hay una nueva tarea.
- La segunda opcion es que el broker solo se encargue de enviar las tareas al Queue y el Consumer va a estar leyendo constanmente para ver si hay una tarea nueva.
Una ventaja muy llamativa de este enfoque es que permite la comunicacion de servicios totalmente aislados
Hay que tener en consideracion que para aprovechar las ventajas de esta solucion, el input de nuestra aplicacion debe ser bastante elevado, los message brokers estan pensados para sistemas distribuidos y con alta carga de peticiones, si contamos con un sistema que no necesata un nivel tan alto de rendimiento, las soluciones 1 y 2 son mas que suficientes